projects/adversarial-lab
Adversarial Lab
AI 安全線上試玩
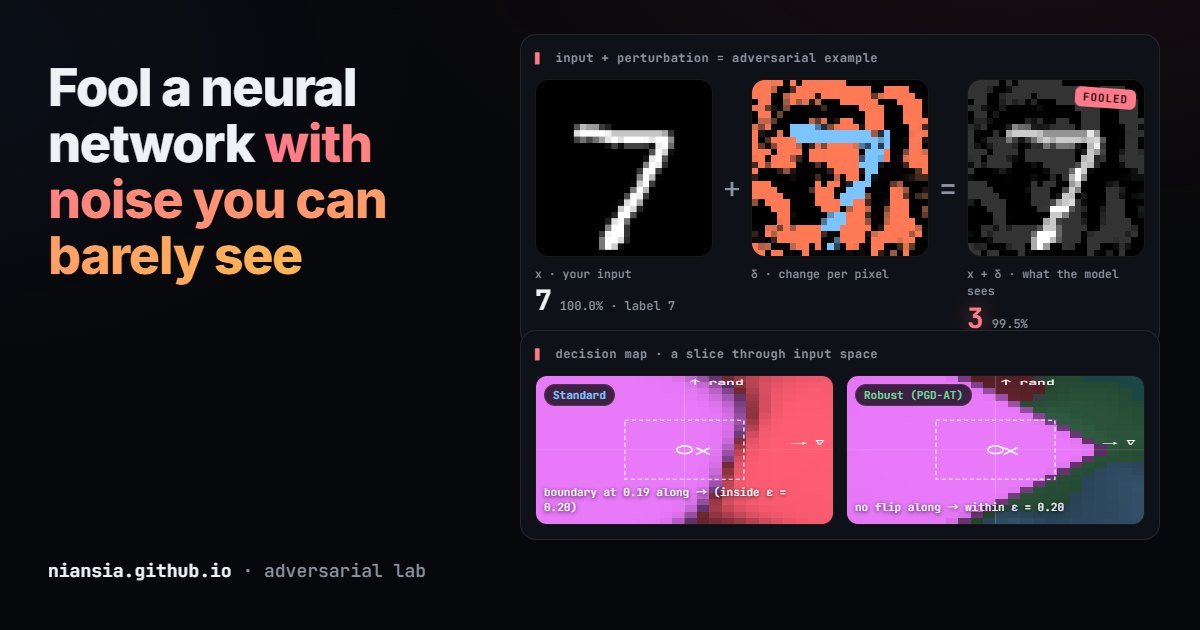
在瀏覽器裡執行的對抗攻擊實驗場:畫一個或挑一個 MNIST 數字,在 L∞ 預算內用 FGSM、PGD 或指定目標的 PGD 攻擊 CNN,一步步看預測被翻轉,再透過梯度、轉移攻擊與輸入空間的決策地圖,和經過 PGD 對抗訓練的模型比較。攻擊所需的梯度用純 JavaScript 在訪客的 CPU 上計算。
佐證
在 2,000 張 MNIST 測試圖上以 PGD-40 評估:一般模型從 98.95% 的乾淨準確率在 ε = 0.2 時掉到 0.2%;對抗訓練模型在 ε = 0.2 仍有 92.2%、ε = 0.3 有 85.3%(乾淨準確率 97.92%)。附梯度遮蔽檢查(每個 ε 下 PGD 都比 FGSM 與轉移攻擊強)、與 PyTorch 誤差在 1e-8 內的 JavaScript 梯度,以及只用 CPU 的訓練與評估腳本。
這是方便分享的精簡頁面;完整、可互動的版本在終端作品集裡。