projects/adversarial-lab
Adversarial Lab
AI 安全在线试玩
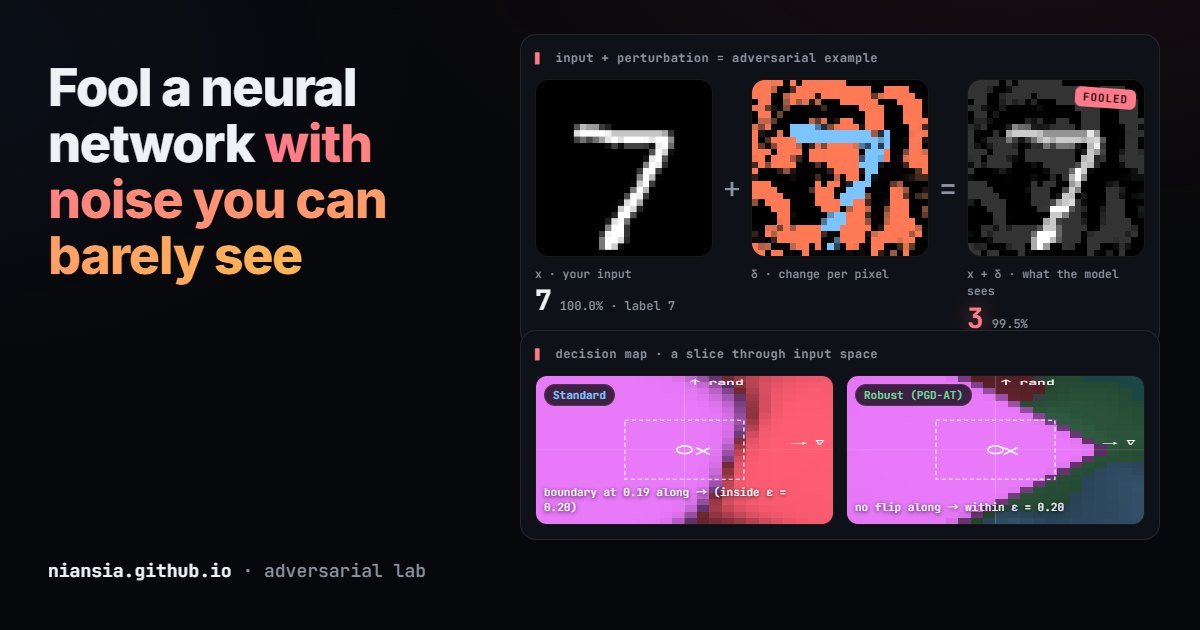
在浏览器里运行的对抗攻击实验场:画一个或挑一个 MNIST 数字,在 L∞ 预算内用 FGSM、PGD 或指定目标的 PGD 攻击 CNN,一步步看预测被翻转,再通过梯度、迁移攻击与输入空间的决策地图,和经过 PGD 对抗训练的模型比较。攻击所需的梯度用纯 JavaScript 在访客的 CPU 上计算。
佐证
在 2,000 张 MNIST 测试图上以 PGD-40 评估:普通模型从 98.95% 的干净准确率在 ε = 0.2 时降到 0.2%;对抗训练模型在 ε = 0.2 仍有 92.2%、ε = 0.3 有 85.3%(干净准确率 97.92%)。附梯度遮蔽检查(每个 ε 下 PGD 都比 FGSM 与迁移攻击强)、与 PyTorch 误差在 1e-8 内的 JavaScript 梯度,以及只用 CPU 的训练与评估脚本。
这是方便分享的精简页面;完整、可交互的版本在终端作品集里。